안녕하세요👋 워크플로우 아키텍트, 수월한입니다.
최근 스포티파이 엔지니어링팀이 자체 개발한 'Portal'이라는 도구로 클로드 코드 토큰 사용량을 90% 줄였다는 사례를 공개했습니다. 대기업 사례라 남 얘기처럼 들리실 수 있는데, 실제로는 개인 개발자도 그대로 따라 할 수 있는 구조입니다.
클로드 코드로 실무를 돌리시는 분이라면, 매달 청구서를 볼 때마다 마음이 무거워지신 적 있으실 겁니다. "이번 달도 왜 이렇게 많이 나왔지" 싶으신 그 순간 말입니다.
이상한 건, 정작 코드를 고치거나 버그를 잡는 대화 자체는 그렇게 비싸지 않다는 점입니다. 진짜 요금이 새는 곳은 따로 있는데, 대부분 그걸 모른 채 "AI가 원래 비싼가 보다" 하고 넘기십니다.
오늘 이 글에서는 스포티파이가 이 문제를 어떻게 막았는지, 그리고 스포티파이의 내부 플랫폼(AiKA·Portal) 없이 클로드 코드의 공개 훅 기능만으로 똑같은 구조를 직접 만드는 법을 정리해드리겠습니다.
- 핵심 변화: PreToolUse 훅으로 대량 작업을 저가 모델에 위임하는 구조를 만들 수 있습니다.
- 실무 적용: 훅 2개와 스킬 1개만 있으면 개인도 그대로 재현할 수 있습니다.
- 기대 효과: 대량 파일 읽기 기준으로 최대 90%까지 토큰을 아낄 수 있습니다.
Before, 클로드 코드 요금이 새는 진짜 지점
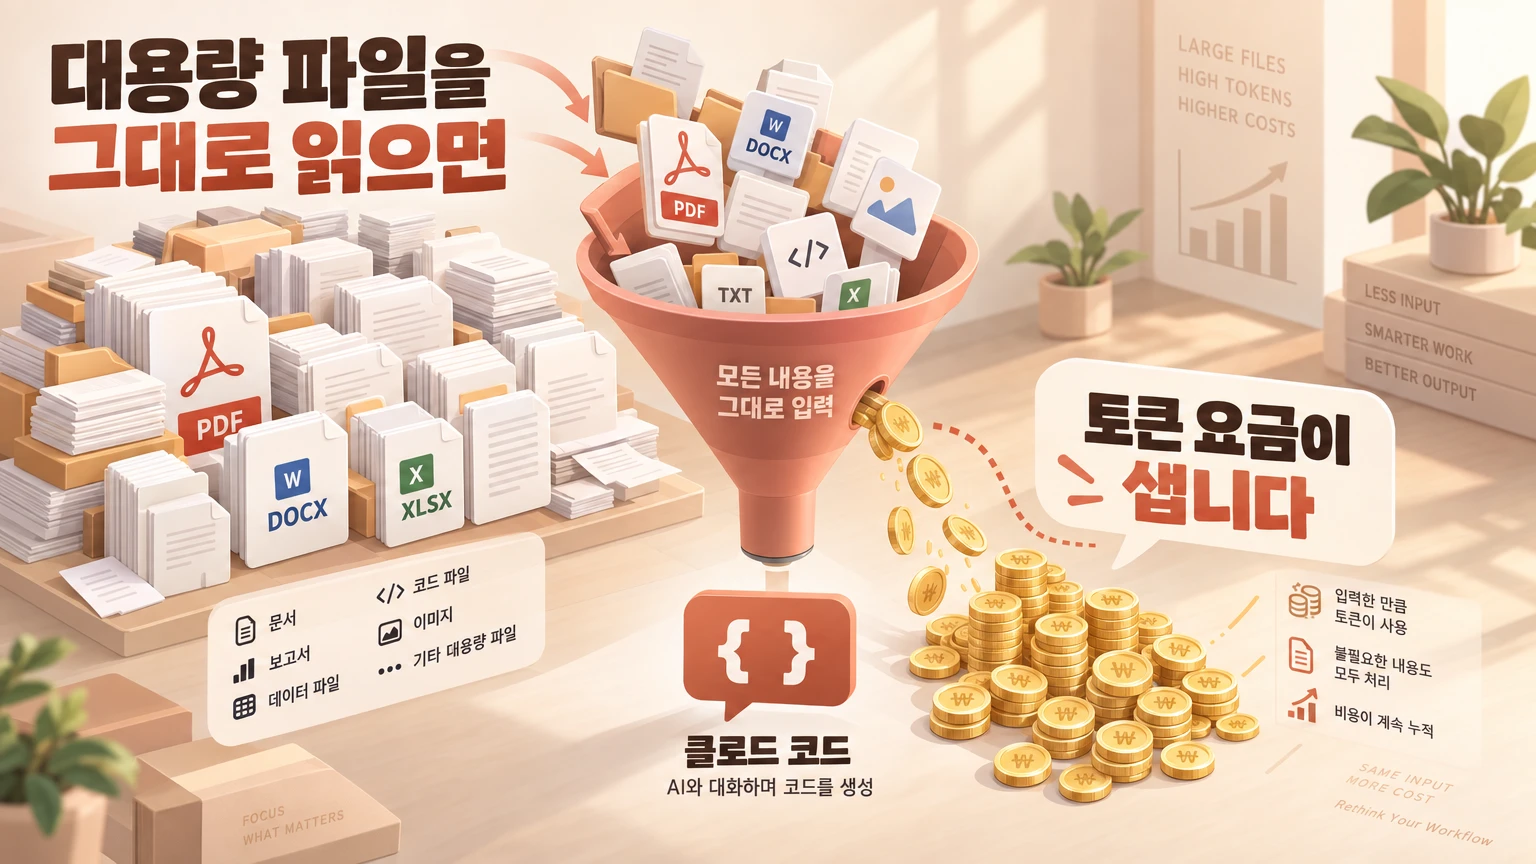
청구서가 무섭다고 하면 다들 "복잡한 로직을 짜달라고 해서 그런가" 생각하십니다. 그런데 실제로 비용이 쌓이는 지점은 따로 있습니다. 대형 로그 파일을 통째로 읽어달라고 하거나, 비슷한 보일러플레이트 코드를 반복해서 생성해달라고 할 때입니다.
클로드 코드는 파일을 읽을 때 그 내용 전체를 컨텍스트에 그대로 밀어 넣습니다. 500줄짜리 로그 파일 하나를 읽는 것도, 그 500줄 전부가 매번 프롬프트에 포함된다는 뜻입니다. 이런 대량 읽기·반복 생성 작업이 하루에 몇 번만 쌓여도, 실제 코딩 로직을 짜는 대화보다 이쪽이 청구서의 더 큰 몫을 차지하게 됩니다.
After, 스포티파이는 이걸 어떻게 막았나
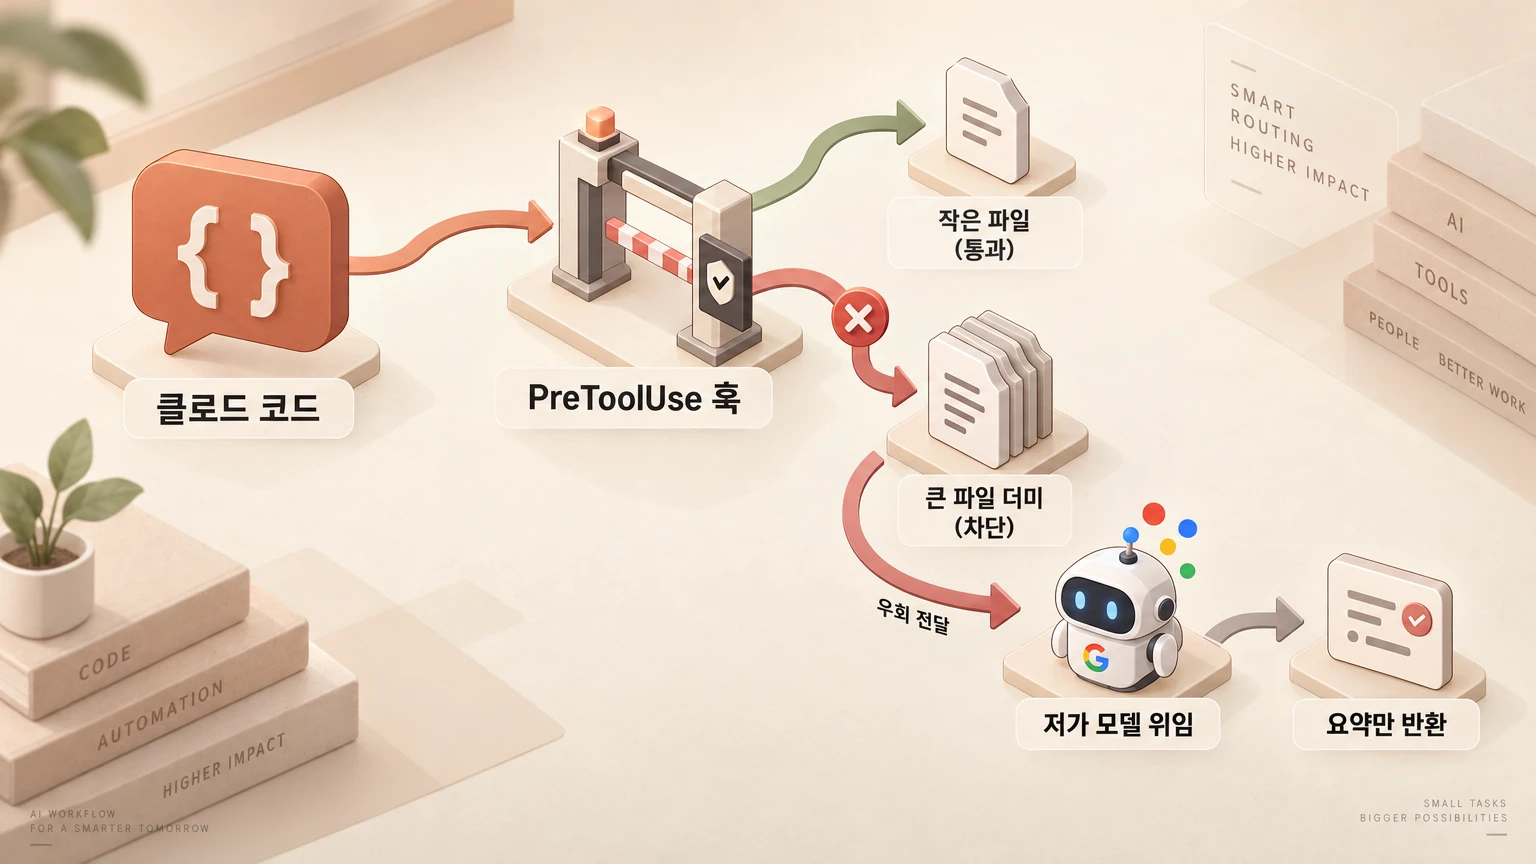
클로드 코드에는 도구를 실행하기 직전에 개입할 수 있는 PreToolUse 훅이라는 공개 기능이 있습니다. 이 훅은 도구 호출을 차단하거나, 입력값을 바꾸거나, 그냥 통과시킬 수 있습니다. 스포티파이는 이 훅을 프롬프트 튜닝이 아니라 아키텍처 차원의 강제 규칙으로 활용했습니다.
정확히는 훅 2개로 구성됩니다. check-file-size는 파일을 읽는 Read 호출마다 발동해서, 파일이 기본 350줄을 넘으면 그 읽기를 차단합니다(이 임계값은 SHUNT_MIN_LINES 환경변수로 조정할 수 있습니다). check-bash-read는 cat·head·tail·less·more 같은 명령어로 대용량 파일에 접근하는 걸 차단합니다(다만 파이프로 연결된 명령어는 그냥 통과시킵니다).
훅이 차단하면 클로드 코드는 그냥 멈추는 게 아니라, bulk-reader나 code-writer라는 스킬을 대신 쓰라는 안내를 받습니다. 이 스킬의 정체가 핵심입니다. 겉으로는 스킬이지만 실제로는 제미나이 2.5 플래시 같은 저가 모델을 호출해서, 그 모델이 파일을 대신 읽고 요약한 결과만 클로드에게 돌려줍니다. 클로드는 원본 파일 전체가 아니라 압축된 답만 받으니 컨텍스트 소비가 크게 줄어듭니다.
스포티파이는 이렇게 해서 대량 읽기(bulk-read) 작업 기준으로 평균 약 90%의 토큰을 아꼈다고 공개했습니다. 다만 이 90%는 전체 세션 비용이 아니라 대량 읽기 작업에 한정된 수치이고, 정확한 계산식이나 4개 시나리오의 세부 수치까지는 공개되지 않았다는 점은 정직하게 말씀드립니다.
Blueprint 1, 준비물
스포티파이의 AiKA·Portal 같은 사내 플랫폼은 없어도 됩니다. 아래 세 가지면 충분합니다.
| 준비물 | 용도 |
|---|---|
| 저가 모델 API 키(제미나이 2.5/3.8 플래시 등) | 대량 읽기·보일러플레이트 생성을 위임받을 모델 |
| 클로드 코드 최신 버전 | PreToolUse 훅 기능 사용 |
jq, python3 |
훅 스크립트에서 JSON 파싱·API 호출 |
제미나이 3.8 플래시는 이 글에서 다룬 것처럼 프로모션가 기준 100만 토큰당 입력 0.75달러, 출력 3.75달러라 위임용으로 부담이 거의 없습니다. 클로드 코드 자체의 비용 구조를 더 깊이 보고 싶으시면 이 글도 함께 참고하시면 좋습니다.
Blueprint 2, 훅 2개 설정하기
.claude/settings.json에 아래처럼 두 훅을 등록합니다.
{
  "hooks": {
    "PreToolUse": [
      {
        "matcher": "Read",
        "hooks": [
          {
            "type": "command",
            "command": "${CLAUDE_PROJECT_DIR}/.claude/hooks/check-file-size.sh",
            "timeout": 10
          }
        ]
      },
      {
        "matcher": "Bash",
        "hooks": [
          {
            "type": "command",
            "if": "Bash(cat *|head *|tail *|less *|more *)",
            "command": "${CLAUDE_PROJECT_DIR}/.claude/hooks/check-bash-read.sh",
            "timeout": 10
          }
        ]
      }
    ]
  }
}
check-file-size.sh는 stdin으로 들어오는 JSON에서 읽으려는 파일 경로를 꺼내, 줄 수가 임계값을 넘으면 차단 결정을 돌려줍니다.
#!/bin/bash
INPUT=$(cat)
FILE_PATH=$(echo "$INPUT" | jq -r '.tool_input.file_path // empty')
THRESHOLD="${SHUNT_MIN_LINES:-350}"

if [ -z "$FILE_PATH" ] || [ ! -f "$FILE_PATH" ]; then
  exit 0
fi

LINE_COUNT=$(wc -l < "$FILE_PATH")

if [ "$LINE_COUNT" -gt "$THRESHOLD" ]; then
  jq -n --arg reason "파일이 ${THRESHOLD}줄을 넘습니다(${LINE_COUNT}줄). bulk-reader 스킬로 요약을 요청하세요." \
    '{hookSpecificOutput: {hookEventName: "PreToolUse", permissionDecision: "deny", permissionDecisionReason: $reason}}'
fi

exit 0
핵심은 exit code입니다. exit 2를 쓰면 클로드 코드가 JSON 결정과 무관하게 무조건 차단하고, 위 스크립트처럼 exit 0에 JSON을 출력하면 그 JSON의 permissionDecision 값대로 처리됩니다. check-bash-read.sh도 같은 방식으로, tool_input.command에서 대상 파일 경로를 추출해 동일하게 줄 수를 검사하면 됩니다.
Blueprint 3, bulk-reader 스킬 만들고 검증하기
훅이 차단하면 클로드는 안내 문구를 보고 bulk-reader 스킬을 스스로 호출합니다. 이 스킬의 실체는 파일을 대신 읽어 저가 모델에 요약을 맡기는 짧은 파이썬 스크립트입니다.
#!/usr/bin/env python3
import sys, os, requests

def main():
    question = sys.argv[1]
    paths = sys.argv[2:]
    contents = []
    for p in paths:
        with open(p, encoding="utf-8") as f:
            contents.append(f"### {p}\n{f.read()}")

    prompt = f"다음 질문에 답하기 위해 아래 파일 내용을 요약해줘: {question}\n\n" + "\n\n".join(contents)

    api_key = os.environ["GEMINI_API_KEY"]
    resp = requests.post(
        f"https://generativelanguage.googleapis.com/v1beta/models/gemini-3.8-flash:generateContent?key={api_key}",
        json={"contents": [{"parts": [{"text": prompt}]}]},
        timeout=30,
    )
    print(resp.json()["candidates"][0]["content"]["parts"][0]["text"])

if __name__ == "__main__":
    main()
이 스크립트를 bulk-reader라는 이름의 스킬로 등록해두면, 클로드는 훅에 막힌 다음 이 스킬에 질문과 파일 경로를 넘기고, 돌아온 요약문만 자기 컨텍스트에 담습니다.
정상 동작 검증: 500줄이 넘는 로그 파일 하나를 준비해서 "이 로그에서 에러 원인을 찾아줘"라고 요청해보십시오. 클로드가 바로 파일을 읽지 않고 차단 메시지를 받은 뒤 bulk-reader를 호출하는지 확인하고, 세션이 끝난 뒤 사용량을 훅 적용 전과 비교해보시면 차이가 바로 체감되실 겁니다.
이 방식이 안 맞는 경우
디버깅이나 설계 판단, 핵심 로직처럼 미묘한 뉘앙스가 중요한 작업에는 이 구조를 쓰지 마십시오. 저가 모델이 요약하는 과정에서 정작 중요한 디테일이 뭉개질 수 있어, 이런 작업은 클로드가 원본을 직접 보고 판단하게 두는 편이 안전합니다.
위임할 때마다 네트워크 왕복으로 10~30초의 지연이 생기고, 스포티파이 쪽 플랫폼은 단일 호출을 30초로 제한해두고 있습니다. 임계값을 너무 낮게(예: 50줄) 잡으면 사소한 파일까지 전부 위임되면서 오히려 답답해질 수 있으니, 350줄 근처에서 시작해 실제 작업 패턴에 맞춰 조정하시길 권합니다.
훅 라우팅은 "어떤 작업을 누구에게 맡길지"를 조정하는 레버이고, 모델 자체의 추론 강도를 조정하는 레버는 따로 있습니다. 클로드 오퍼스 계열을 쓰신다면 이 글에서 다룬 Effort 레벨 조정도 함께 챙기시면 청구서를 더 줄일 수 있습니다.
맺음말
매달 청구서를 보고 마음이 무거워지셨던 분이라면, 오늘 이 글을 읽으신 김에 훅 2개부터 먼저 켜보시길 권해드립니다. 스포티파이의 전체 시스템을 그대로 옮길 필요는 없습니다. check-file-size 훅 하나만 켜도, 청구서에서 가장 큰 덩어리가 실제로 어디서 나오는지 바로 보이실 겁니다.
자주 묻는 질문(FAQ)
가능합니다. 이 구조에서 중요한 건 특정 모델이 아니라 "저렴하고 빠른 모델에 단순 반복 작업을 위임한다"는 원칙입니다. bulk-reader 스크립트의 API 호출 부분만 원하는 모델의 엔드포인트로 바꾸면 그대로 동작합니다.
훅 자체는 파일 크기만 확인하는 짧은 스크립트라 체감될 정도의 지연은 없습니다. 다만 임계값을 넘어 실제로 위임이 일어나는 경우에는 10~30초의 네트워크 왕복 지연이 추가로 발생합니다.
원리 자체는 도구를 가리지 않습니다. 다만 이 글에서 설명한 PreToolUse 훅은 클로드 코드의 기능이라, 다른 도구에서 그대로 쓰려면 그 도구가 제공하는 훅이나 플러그인 인터페이스로 같은 로직(대용량 작업 감지 후 저가 모델로 위임)을 다시 구현해야 합니다.
'🛠️ 수월한 시스템 & 워크플로우 > AI 연동 시스템 & 워크플로우' 카테고리의 다른 글
| 나노 바나나 프로 12개 직무별 활용 방식과 성과 총정리 (나노 바나나 프로 실무 가이드 1편) (0) | 2025.12.01 |
|---|---|
| Gemini AI 함수 실전: 구글 시트로 지옥의 고객 리뷰(VOC) 분류 5분 컷 하기 (0) | 2025.11.26 |